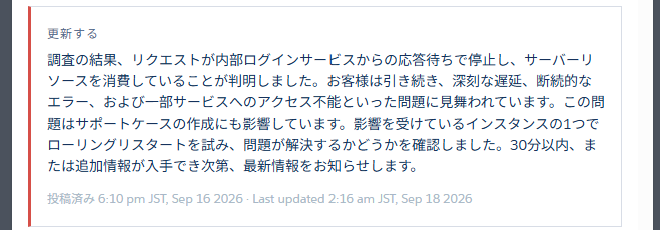
久々のSalesforce障害。
しかも大規模で、世界中に影響が波及した模様。
それもDreamforceに。
↓
原因
https://status.salesforce.com/incidents/20004433
Xを覗いてみると、「ラッキー、今日は仕事終わり」といった声も上がっているが
アドミン職の方々はそうは言ってられない。
障害が発生したら業務も、サービスも停止してしまうため
Salesforceが復旧するまでの間は対策を考えておく必要がある。
昔よくやっていたのはシステム停止用のエクセルファイルを準備しておき
あとからDataloaderなどでデータ取り込みする方法。
業務側はそれで対応できるかもしれないが、データの整合性が気になるし、
データやログの損失も懸念される。
エンドユーザ向けのサービスにおいては機会損失となり、その影響は計り知れない。
エンドユーザ向けのサービスの場合は、
・オフライン機能の提供(クライアント側にデータ保持:)
・別サーバーでミラーリングしたアプリを提供
等が考えられるか。
■オフライン機能の実現方法
・ブラウザの IndexedDB や LocalStorage、またはモバイルアプリ内の SQLite 等にローカルデータを保持
・ネットワーク切断(またはサーバー応答エラー)を検知すると、更新系リクエストをローカルストレージ内のキュー( Queue )に保持
・復旧後にバックグラウンドでキューを順次処理し、本番環境へ同期
↓
課題は…
・コンフリクト(データ衝突)の解消: 障害中に複数のユーザーが同じデータを編集した場合、どちらを優先するか(「最後勝ち」「手動競合解消」など)のロジック構築が必要。
・端末ストレージ容量: 大容量データやメディアファイルの保持には向かない。
■別サーバーでミラーリングする方法
・平常時に Salesforce のデータを CDC(Change Data Capture)や定期バッチで別DB(AWS AuroraやFirestore等)へリアルタイム同期。
・障害検知時、DNS(Route 53等)やロードバランサーでトラフィックを代替アプリ(リードオンリーモード)へ切り替え。
↓
課題は…
・書き込みの扱い(スプリットブレイン問題): 待機系サーバー側でデータの新規作成・更新を許可してしまうと、本番復旧時の書き戻し(フェイルバック)と整合性チェックが非常に複雑化する。
・同期遅延(RPO): Salesforceダウン直前の数秒〜数分間のデータはミラー側に反映されていない可能性がある
■その他の手法
・ソーシャルログイン・認証基盤の分離: 認証自体をSalesforceや単一のIdentity Providerに依存していると全サービスからシャットアウトされるため、認証基盤の冗長化やフォールバックを用意する。
・静的フォールバックページ(ソーリーページ)とステータス表示:CloudflareやAWS CloudFront等のCDN層で障害を検知し、「現在メンテナンス中/障害発生中」の静的ページへ自動切り替え。
・キューイング(Cloudflare Waiting Room等): 一時的な負荷過多や部分障害の場合、ユーザーを仮想的な待合室に誘導し、システム崩壊を防ぐ。
・リードオンリー・キャッシュ(CDNキャッシュの活用): 障害発生時でも、CDN上のキャッシュ(Stale-While-Revalidate等)を返却することで、少なくとも最新データの閲覧だけは維持する。
